
Pourquoi la fiabilité d’un système d’intelligence artificielle dépend d’abord du travail humain qui prépare ses données, avant même de parler de modèle.
Quand un dirigeant décide d’intégrer l’intelligence artificielle à son activité, la question qu’il se pose porte presque toujours sur l’outil : quel modèle choisir, quel fournisseur retenir. Une autre question compte tout autant. Elle reste presque toujours dans l’angle mort : qui a préparé les données qui permettent à l’IA d’automatiser des tâches sans bouleverser les process déjà en place.
Ce travail n’a rien d’anodin : il demande du temps et de la réflexion. Un modèle d’IA ne connaît rien de votre activité au départ. Entraîné sur des données génériques, il rendra des réponses génériques, sans rapport avec les dossiers que vos équipes traitent chaque jour. Préparer les données revient à traduire ce travail réel en exemples : quels documents arrivent et quelle décision on prend face à chacun, y compris dans les cas qui sortent de l’ordinaire. Ce contexte, seuls des professionnels qui connaissent le terrain et savent comment une IA apprend peuvent le transmettre à l’outil. La fiabilité d’une IA se joue avant le premier calcul, dans la main qui a annoté la donnée qu’elle va apprendre.
Cet article explique concrètement comment se déroule ce travail de préparation et ce qu’il change pour la fiabilité d’un outil d’IA que vous mettez entre les mains de vos équipes ou de vos clients.
Une IA ne voit rien, elle répète ce qu’on lui a montré
Un outil d’IA ne peut pas comprendre un document comme le ferait un collaborateur. Il compare ce qu’il reçoit à des centaines d’exemples qu’on lui a montrés pendant son entraînement, chacun accompagné d’une étiquette qui dit de quoi il s’agit : une facture à payer ou une réclamation à transmettre au service client. Cette masse d’exemples étiquetés lui apprend où tracer la limite entre un cas et un autre.
Si une partie de ces étiquettes est imprécise, par exemple des avoirs classés comme des factures, l’outil apprend une frontière légèrement fausse. Répétée sur tout un lot de documents, cette imprécision devient une erreur qui se reproduit une fois l’outil en service. Il continue de tourner et de rendre des résultats, mais il se trompe d’une manière difficile à repérer, parce que l’erreur ne vient jamais du calcul : elle vient de ce qu’on lui a montré avant.
C’est pour ça que la préparation des données, souvent invisible dans la présentation d’un projet d’IA, en constitue en réalité le socle.
À quoi ressemble ce travail au quotidien
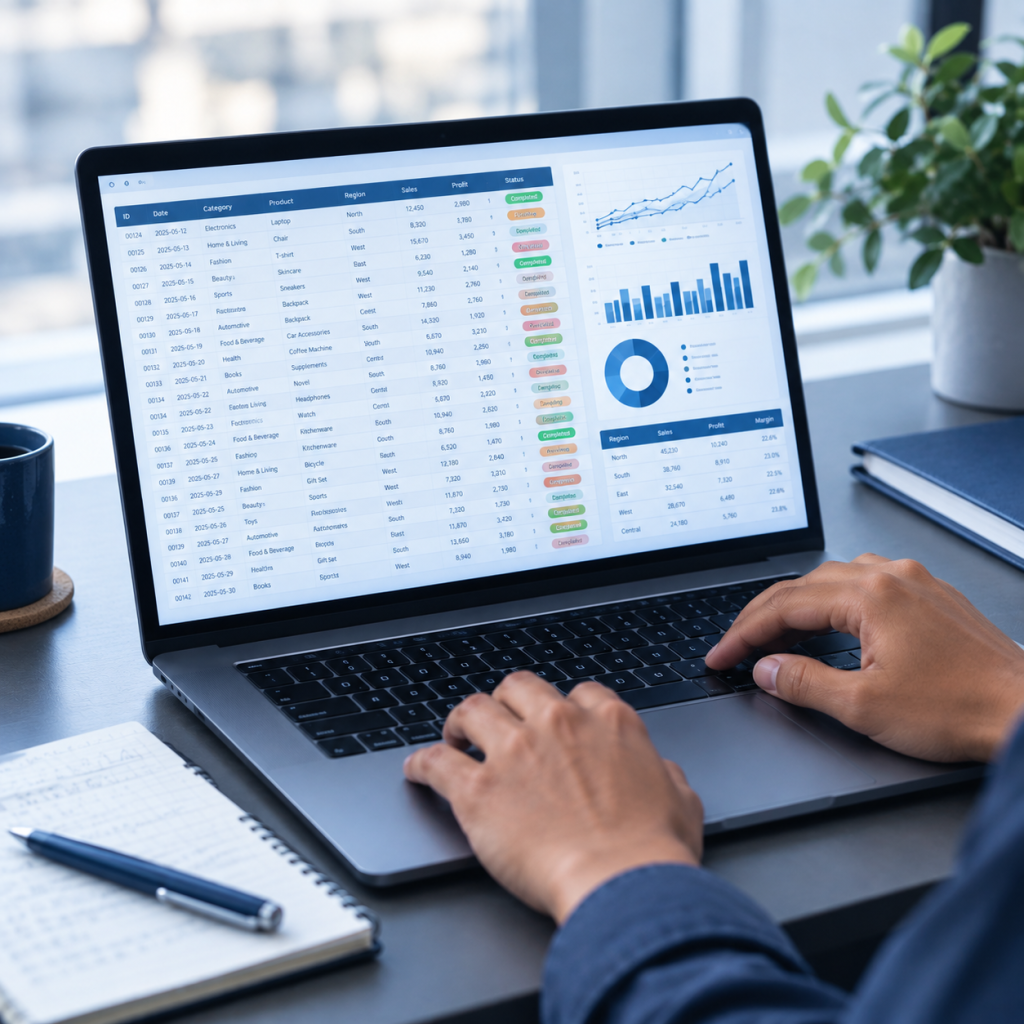
Prenons une PME qui veut automatiser le tri des documents reçus par son service comptable. Avant que l’outil puisse faire ce tri seul, une personne spécialisée dans la préparation des données doit reprendre les 500 pièces reçues sur les 6 derniers mois, indiquer pour chacune de quoi il s’agit et noter la décision que l’équipe a prise : payée tout de suite ou mise en attente pour vérification.
Le temps passe surtout sur les documents ambigus, comme une facture sans numéro de commande ou un avoir présenté comme une facture. Pour chacun, il faut trancher puis écrire la règle, afin que le cas suivant soit traité de la même façon. Ces règles ne s’écrivent pas en une journée : elles s’enrichissent à chaque nouveau cas ambigu, au fil des semaines passées sur les mêmes documents.
Ce travail doit être confié à une personne qui comprend comment une IA apprend à partir des exemples qu’on lui donne et qui connaît les process de l’entreprise. Elle travaille directement avec les équipes concernées par l’outil, les comptables dans notre exemple, pour le mettre au point à partir de leurs vraies pratiques. Ce travail demande aussi une personne chargée du contrôle qualité, qui revérifie un échantillon des documents préparés pour repérer les écarts avant qu’ils ne se retrouvent dans le modèle.
Une fois les données prêtes, l’outil passe d’abord par une phase de test. On lui soumet des documents qu’il n’a jamais vus, par exemple les pièces du mois en cours, puis on compare ses réponses à celles des comptables. Tant qu’il se trompe sur des cas que l’équipe juge simples, on revient aux exemples pour les corriger. L’outil n’est déployé dans le travail quotidien du service comptable qu’une fois qu’il a fait ses preuves sur ces tests.
Pourquoi une petite équipe stable fait mieux qu’un vivier dispersé
Beaucoup d’entreprises confient la préparation de leurs données à des plateformes de micro-tâches ou à des freelances qui tournent d’un projet à l’autre. La méthode coûte peu à l’unité et va vite. Elle a aussi une limite concrète : chaque nouvelle personne applique sa propre lecture des cas limites, sans mémoire des décisions prises la veille par quelqu’un d’autre. Sur une tâche simple, l’écart reste négligeable. Sur des documents où la différence entre deux cas tient à un détail, cet écart devient le bruit qui dégrade la fiabilité de l’outil final.
Une équipe dédiée qui reste stable sur la durée du projet ne pose pas ce problème. Elle applique le même jugement du premier jour au trois centième, parce que ce sont les mêmes personnes qui l’appliquent. La collaboratrice chargée du contrôle qualité joue le même rôle qu’une relecture croisée dans n’importe quel métier exigeant : elle repère les erreurs qui commencent à se répéter et les fait corriger tout de suite, plutôt que de les découvrir une fois l’outil en service.
Comment une équipe dédiée s’organise, concrètement
Une équipe dédiée à ce travail se monte comme toutes les équipes dédiées chez ScaleMyCrew : des collaborateurs salariés en CDI, basés dans nos bureaux à Antananarivo, la capitale de Madagascar. Elle démarre en général à un ou deux postes, le temps de valider la méthode sur un premier lot de données. Un renfort pour le contrôle qualité ou un profil technique s’ajoute ensuite quand le volume le justifie, jamais par automatisme.
Le travail se fait dans les outils du client, par exemple Slack pour les échanges et Notion pour écrire les règles de classement. La méthode reste ainsi lisible, même si quelqu’un doit un jour reprendre le travail d’un collègue. Un profil technique peut écrire des scripts Python qui vérifient automatiquement des critères simples, un document illisible ou en double par exemple. Les autres gardent ainsi leur temps pour les cas qui demandent un vrai jugement. Un account manager basé en Europe suit la relation dans la durée et fait remonter tout signal qui mérite l’attention du client avant que ça devienne un problème.
On commence petit pour prouver la méthode sur un premier lot, puis l’équipe grandit au rythme réel du besoin.
Ce que ça change pour votre activité
Le premier bénéfice se mesure en confiance dans ce que produit votre outil d’IA. Un modèle entraîné sur des données mal préparées se trompe en silence, jusqu’au jour où l’erreur remonte chez un utilisateur ou un client, souvent au pire moment. Soigner la préparation des données en amont coûte moins cher que de corriger un outil défaillant une fois déployé.
Le deuxième bénéfice tient au coût. Le même budget qu’un profil moyen en Europe permet de trouver des profils du haut du panier à Madagascar. C’est un coût avantageux qui permet de garantir une qualité élevée sur tout le projet.
Le troisième bénéfice est moins attendu. Préparer des données pour une IA oblige à écrire, noir sur blanc, les critères qui séparent un cas d’un autre. Beaucoup d’entreprises découvrent, en posant ce cadre, que ces critères n’avaient jamais été formalisés en interne. Une fois écrits, ils servent bien au-delà du projet d’IA : ils deviennent la référence commune de toute l’équipe.
FAQ : ce que les dirigeants demandent sur l’annotation de données
Une IA fiable commence toujours par un travail qu’on ne voit pas
Un système d’intelligence artificielle donne l’impression de faire le travail tout seul. Il ne fait que répéter, à grande échelle, ce qu’on lui a montré patiemment, document après document. Cette préparation reste invisible dans les présentations commerciales et les démonstrations. Elle est pourtant la seule chose qui sépare une IA fiable d’une IA qui se trompe sans qu’on le sache.
Si vous vous demandez comment structurer une équipe d’annotation ou de contrôle qualité pour un projet d’IA, parlons-en. On part toujours du volume et des critères de votre projet avant de recommander une organisation.
Publié le 28/09/2026